Wöchentliches KI-Briefing — direkt ins Postfach.
Danke! Schau in dein Postfach.
Mehr Newsletter-Formate →

Stand: 28.10.2026
Alle Beispiele haben wir im DECAID-Demo-Workspace mit der fiktiven Firma Quellberg getestet. Firmen, Preise und Anfragen im Praxisfall sind erfunden.
Kurz gesagt: In Langdock arbeitest du mit Modellen von OpenAI, Anthropic, Google und weiteren Anbietern unter einer Oberfläche. Standardmäßig sind nur Modelle aktiv, die in der EU gehostet werden. In unserem Vergleich rechneten neun aktuelle Modelle dieselbe Angebotsaufgabe, acht davon in allen drei Läufen richtig. Der große Unterschied lag bei den Kosten: Für drei Läufe zahlten wir zwischen rund 0,01 USD und 0,48 USD.
Welche Modelle du siehst, entscheiden deine Admins. Sie schalten Modelle unter Einstellungen › Workspace › Modelle frei. Neue Modelle hat Langdock zuletzt jedes Mal automatisch freigeschaltet, wenn im Workspace ein Vorgänger aktiv war (Quelle: Langdock-Changelog, Langdock-Doku »Workspace-Einstellungen«).
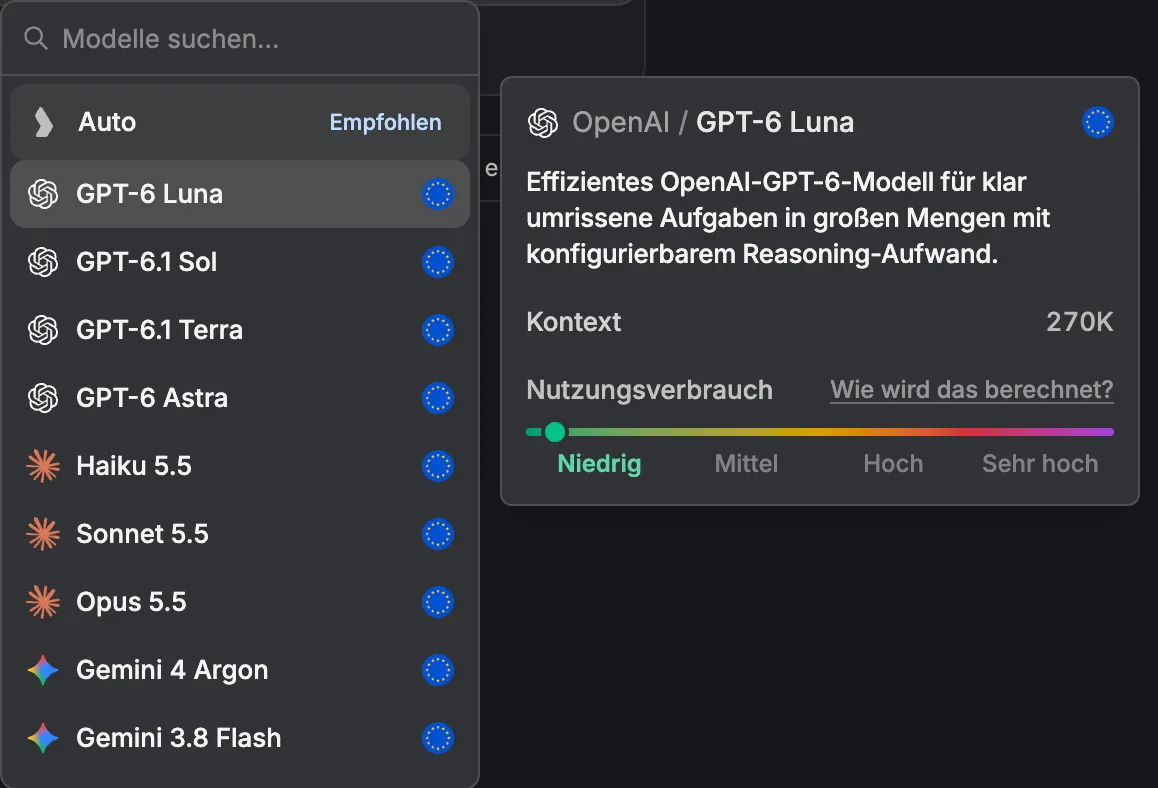
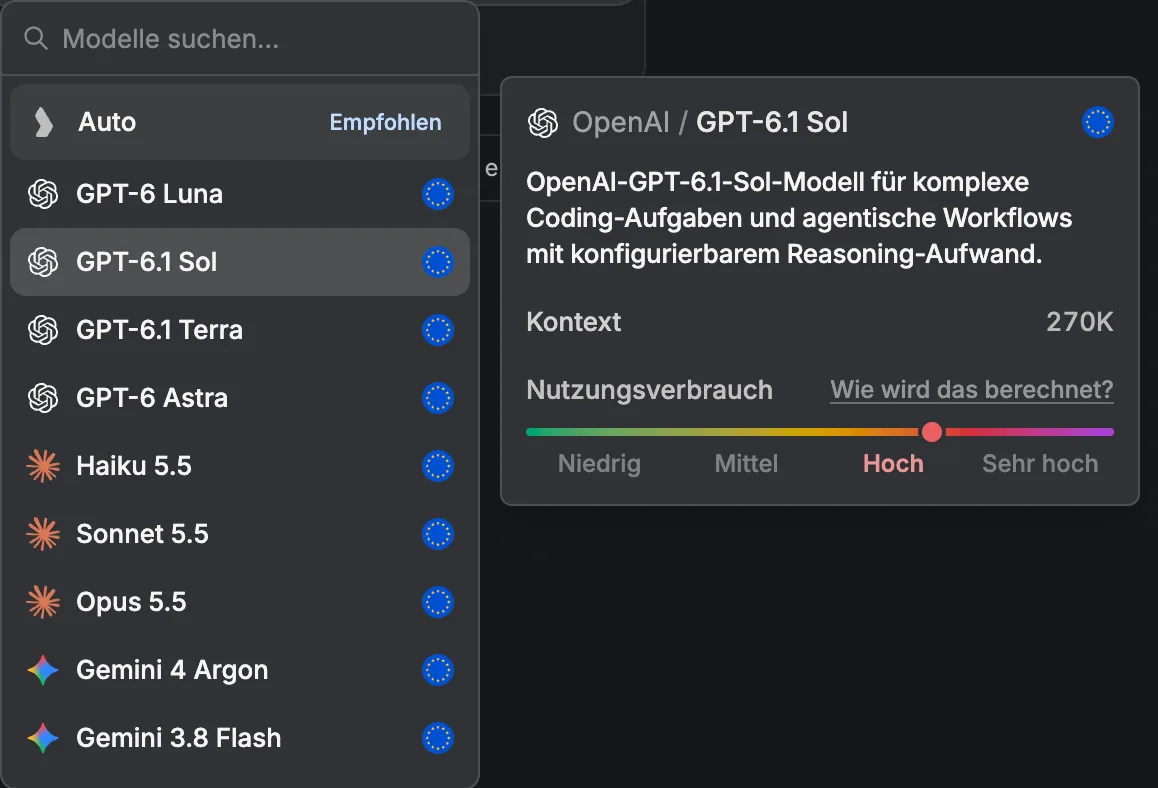
Die neuesten Modelle in unserem Workspace, Stand 28.10.2026 (Quelle: Langdock-Changelog; Kontext, Nutzungsverbrauch und Einsatzzweck aus der Modellvorschau im Quellberg-Workspace):
| Modell | Anbieter | Verfügbar seit | Kontext | Nutzungsverbrauch | Wofür laut Langdock |
|---|---|---|---|---|---|
| GPT-6.1 Terra | OpenAI | 27.10.2026 | 270K | Niedrig | alltägliche professionelle Arbeit, Coding und Analyse |
| Gemini 4 Argon | 13.10.2026 | 200K | Mittel | lange mehrstufige Aufgaben, Analyse langer Dokumente | |
| Haiku 5.5 | Anthropic | 08.10.2026 | 270K | Niedrig | Zusammenfassungen, Subagenten, große Mengen |
| GPT-6.1 Sol | OpenAI | 30.09.2026 | 270K | Hoch | komplexes Coding, agentische Workflows |
| Sonnet 5.5 | Anthropic | 28.09.2026 | 300K | Hoch | Coding, Agenten, Schreiben und Analyse |
| GPT-6 Luna | OpenAI | 23.09.2026 | 270K | Niedrig | klar umrissene Aufgaben in großen Mengen |
| Opus 5.5 | Anthropic | 23.09.2026 | 300K | Sehr hoch | komplexes Reasoning, Softwareentwicklung, langlaufende Agenten |
| GPT-6 Astra | OpenAI | 07.09.2026 | 270K | Sehr hoch | komplexes Reasoning, Coding, Recherche, Dokumente |
| Gemini 3.8 Flash | 02.09.2026 | 200K | Niedrig | schnelle agentische Coding-Workflows, multimodale Aufgaben |
Dazu kommt GPT-6 Sol vom 23.09.2026, der Vorgänger von GPT-6.1 Sol. Im Katalog stehen außerdem ältere Generationen, Fable 5.1 von Anthropic (mit erweiterter Datenspeicherung beim Anbieter), Modelle von Mistral und Bildmodelle wie GPT Image 2.5. Mehr zur Datenspeicherung steht in unserem Artikel zum Datenschutz.
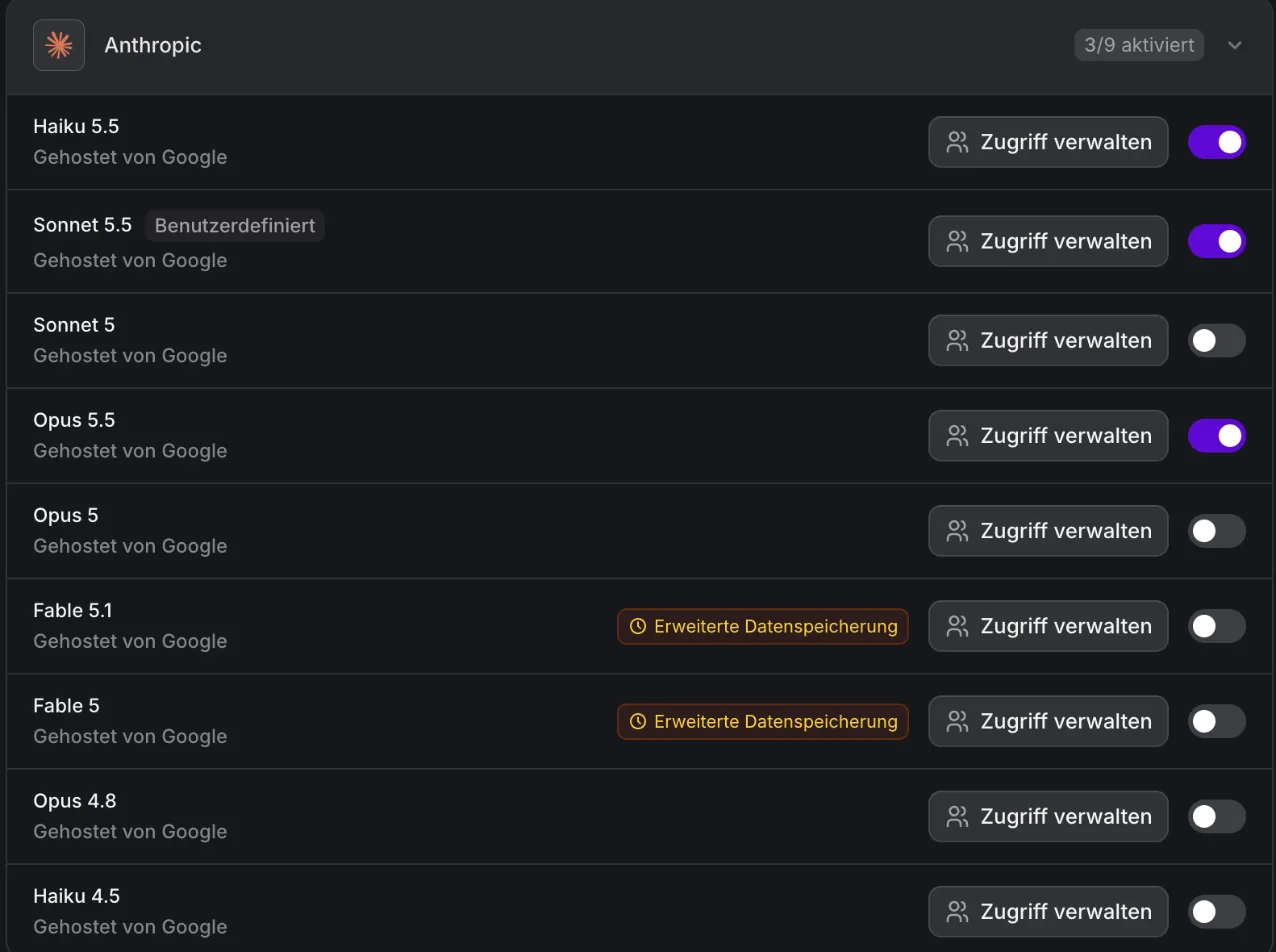
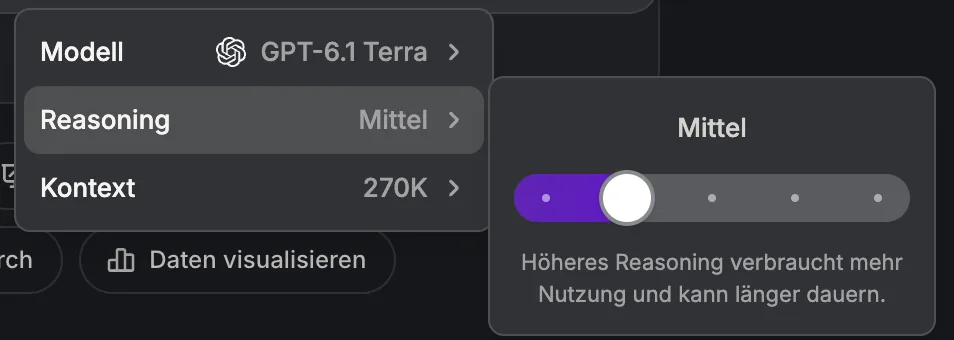
Fährst du in der Modellauswahl über ein Modell, zeigt Langdock eine Vorschau mit Beschreibung, Kontext und Nutzungsverbrauch.
Quellbergs Innendienst wollte wissen, welches Modell für Angebote reicht. Wir haben allen neun freigeschalteten Modellen dieselbe Aufgabe gegeben, je dreimal: eine Preisliste mit drei Artikeln, Pfand, Rabattstaffel und Frachtregel, dazu eine Anfrage über 40, 35 und 25 Kisten gelisteter Artikel und 10 Kisten Rhabarberschorle, die nicht in der Liste steht. Gefragt war die Rechnung und eine kurze Antwortmail. Getestet haben wir über die Langdock-API, mit einem Agenten, dessen einzige Anweisung »Du antwortest auf Deutsch.« war.
Die Aufgabe hatte drei Fallen: Die gelisteten Kisten ergeben genau 100, also die Grenze zur 8-%-Stufe. Die Rhabarberschorle darf nicht mitgerechnet werden. Und der Hinweis »nur nach Freigabe« gilt nur für die 12-%-Stufe. Richtig ist: Warenwert 2.092,00 EUR, Rabatt 167,36 EUR, Pfand 342,00 EUR, gesamt 2.266,64 EUR.
| Modell | richtig | Dauer im Schnitt | Kosten für 3 Läufe |
|---|---|---|---|
| GPT-6 Luna | 3 von 3 | 9,4 s | 0,01 USD |
| Haiku 5.5 | 2 von 3 | 9,3 s | 0,01 USD |
| GPT-6.1 Terra | 3 von 3 | 10,1 s | 0,04 USD |
| Gemini 3.8 Flash | 3 von 3 | 40,2 s | 0,05 USD |
| Gemini 4 Argon | 3 von 3 | 19,9 s | 0,05 USD |
| Sonnet 5.5 | 3 von 3 | 6,4 s | 0,08 USD |
| GPT-6.1 Sol | 3 von 3 | 17,8 s | 0,09 USD |
| Opus 5.5 | 3 von 3 | 12,9 s | 0,19 USD |
| GPT-6 Astra | 3 von 3 | 14,8 s | 0,48 USD |
Getestet über die Langdock-API am 28.10.2026 mit der Standard-Reasoning-Stufe des jeweiligen Modells (GPT-6 Luna »Hoch«, Sonnet 5.5 »Leicht«, alle übrigen »Mittel«). Dauer bis zur fertigen Antwort. Kosten laut Nutzungsexport von Langdock, der auf volle Cent rundet; bei GPT-6 Luna und Haiku 5.5 lagen sie deshalb irgendwo unter 2 Cent. Sonnet 5.5 ist in unserem Workspace als »Benutzerdefiniert« markiert; ob dort Werte vom Standard abweichen, haben wir nicht geprüft.
Die Befunde 1 bis 5 stammen aus Tests am 28.10.2026 im Quellberg-Workspace (Cloud, ohne BYOK), Befund 6 aus dem Langdock-Changelog.
1. Für klar beschriebene Aufgaben reicht ein günstiges Modell. GPT-6 Luna rechnete alle drei Läufe richtig, je Lauf in rund 9 Sekunden, für alle drei zusammen für rund einen Cent. GPT-6 Astra kam zu denselben Zahlen, legte das Angebot aber als Datei an und kostete 0,48 USD. Wenn die Aufgabe alle Regeln enthält, bringt ein teures Modell bei so einer Rechnung keinen Vorteil.
2. Ein kleines Modell las eine Regel anders. Haiku 5.5 bezog in einem Lauf »nur nach Freigabe« auf die 8-%-Stufe, rechnete ohne Rabatt und schrieb 2.434,00 EUR in die Mail. Die richtige Summe nannte es nur als Variante. Bei Regeln mit Ausnahmen lohnt eine eindeutige Formulierung (»Die Freigabe gilt nur für die 12-%-Stufe«) oder ein Test mit mehreren Läufen. Ob die eindeutige Formulierung reicht, haben wir nicht nachgetestet.
3. Über die API legen manche Modelle Dateien an. GPT-6.1 Sol und GPT-6 Astra schrieben das Angebot in allen drei Läufen als Markdown-Datei, GPT-6.1 Terra in zwei Läufen. Im Antworttext stand nur ein Satz wie »… sind im Dokument erstellt.« Die Dateien waren richtig. Die Abhilfe haben wir gegengeprüft: Mit der Anweisung »Antworte immer direkt im Chat-Text und lege keine Dateien an« antwortete GPT-6.1 Sol in drei von drei Läufen im Text, richtig und in rund 9 statt 18 Sekunden. Wer die Antwort in einer eigenen Anwendung weiterverarbeitet, schreibt das in die Anweisung. Im Chat haben wir das Verhalten nicht getestet.
4. Tempo und Kosten hängen kaum zusammen. Sonnet 5.5 war mit 6,4 Sekunden im Schnitt am schnellsten, liegt beim Nutzungsverbrauch aber bei »Hoch«. Es lief auf seiner Standardstufe »Leicht«, GPT-6 Luna auf »Hoch«. Gemini 3.8 Flash steht bei »Niedrig«, kostete im Test aber so viel wie Gemini 4 Argon und war am langsamsten: 26 Sekunden ohne Werkzeug, 40 und 55 Sekunden in den beiden Läufen, in denen es Code ausführte, um nachzurechnen und die Wörter der Mail zu zählen.
5. Die Kosten liegen weit auseinander. Für dieselbe Aufgabe lagen die Kosten zwischen rund 0,01 USD und 0,48 USD für drei Läufe. Das deckt sich grob mit der Skala in der Modellauswahl: Luna, Haiku und Terra stehen bei »Niedrig«, Opus und Astra bei »Sehr hoch«. Ausreißer war Gemini 3.8 Flash, das durch seine Werkzeugschritte so viel kostete wie Gemini 4 Argon. Das passt zu Langdocks eigenem Hinweis, dass die Skala eine Näherung ist und ein Modell mit niedrigen Tokenpreisen mehr vom Limit verbrauchen kann, wenn es mehr Tokens braucht.
6. Neue Modelle kommen schnell, und manchmal von selbst. Zwischen 02.09. und 27.10.2026 kamen zehn neue Chat-Modelle dazu. Alle zehn hat Langdock automatisch dort freigeschaltet, wo ein Vorgänger aktiv war (Quelle: Langdock-Changelog). Admins sollten die Modellliste deshalb regelmäßig prüfen, auch wegen Datenschutz-Etiketten wie »Erweiterte Datenspeicherung«.
| Aufgabe | Unsere Wahl | Warum |
|---|---|---|
| Alltag im Chat | Auto | Langdock wählt je Chat ein passendes Modell und schont Limits |
| Eigene Agenten und Workflows | zuerst GPT-6 Luna oder GPT-6.1 Terra | im Test richtig, schnell, Nutzungsverbrauch Niedrig |
| Texte mit gutem Ton, Code | Sonnet 5.5 | laut Doku stark bei Schreiben und Code, in unserem Test am schnellsten |
| Lange Dokumente | Gemini 4 Argon | laut Langdock für lange Dokumente gebaut |
| Schwere Analyse mit hoher Tragweite | Opus 5.5 oder GPT-6.1 Sol mit höherem Reasoning | mehr Tiefe, dafür Nutzungsverbrauch Hoch bis Sehr hoch |
Wenn ein günstiges Modell in deinem Test nicht reicht, hebe es eine Stufe an und teste neu. So bleiben teure Modelle für die Aufgaben, die sie brauchen.
| Grenze | Was gilt | Was du tun kannst | Quelle |
|---|---|---|---|
| Verfügbarkeit | nur Modelle, die Admins freigeschaltet haben | Admin fragen | Doku »Workspace-Einstellungen« |
| Abschaltung | Anbieter ziehen ältere Modelle zurück, etwa Llama 4 Maverick am 19.11.2026 | Agenten, Workflows und API-Aufrufe vorher auf ein neueres Modell umstellen | Release Notes v7.24 |
| Neue Modelle | erscheinen teils später als beim Anbieter | Changelog verfolgen | Doku »Modellguide« |
| Kontext | standardmäßig 200K bis 300K Tokens, bei sieben von neun Modellen in unserem Workspace zusätzlich 1M in der Zeile Kontext | 1M nur für lange Unterlagen wählen, sonst große Dateien in Wissenssammlungen | Modellauswahl, Stand 30.10.2026 |
| Nutzungs-Limits | teure Modelle verbrauchen Limits schneller | günstige Modelle für Routine, Auto als Standard | Doku »Nutzungs-Tipps« |
| Reasoning | höhere Stufe kostet mehr und dauert länger | Stufe je Aufgabe wählen | Oberfläche, Stand 28.10.2026 |
Welches ist das beste Modell in Langdock?
Das hängt von der Aufgabe ab. In unserem Test rechneten acht von neun Modellen eine Angebotsaufgabe in allen Läufen richtig, die Kosten lagen aber zwischen rund 0,01 USD und 0,48 USD für drei Läufe. Für den Alltag empfehlen wir Auto, für eigene Agenten zuerst ein günstiges Modell wie GPT-6 Luna.
Gibt es Claude in Langdock?
Ja. Im Quellberg-Workspace sind Haiku 5.5, Sonnet 5.5 und Opus 5.5 von Anthropic freigeschaltet, im Katalog stehen weitere Claude-Modelle wie Fable 5.1. Gehostet werden sie in der EU.
Was ist der Unterschied zwischen Langdock und ChatGPT oder Claude direkt?
Langdock bündelt Modelle mehrerer Anbieter in einer Oberfläche mit gemeinsamen Agenten, Integrationen und Admin-Einstellungen. Du wechselst das Modell, ohne das Werkzeug zu wechseln. Die Claude-Modelle laufen in Langdock in der EU; Fable 5.1 trägt das Etikett »Erweiterte Datenspeicherung«, weil der Anbieter dort Ein- und Ausgaben bis zu 30 Tage speichert (Quelle: Langdock-Doku »Workspace-Einstellungen«).
Was bedeutet »Nutzungsverbrauch«?
Die Skala in der Modellauswahl zeigt, wie schnell ein Modell deine Nutzungs-Limits aufbraucht. Laut der Erklärung hinter »Wie wird das berechnet?« ordnet Langdock jedes Modell nach seinen durchschnittlichen Promptkosten auf der Plattform ein. Der tatsächliche Verbrauch hängt von der Aufgabe und von den Tokens für Prompt und Antwort ab, ein Modell mit niedrigeren Tokenpreisen kann also mehr vom Limit verbrauchen, wenn es mehr Tokens braucht (Quelle: Modellauswahl, Langdock-Doku »Nutzungs-Limits«).
Kann ich das Modell mitten im Chat wechseln?
Ja, über die Modellauswahl im Eingabefeld. Bei Auto legt die erste Nachricht das Modell für den Chat fest, ein manueller Wechsel geht trotzdem jederzeit.
Wie oft kommen neue Modelle dazu?
Häufig. Zwischen 02.09. und 27.10.2026 kamen zehn neue Chat-Modelle in Langdock an (Quelle: Langdock-Changelog).
Euer Team fragt sich, welches Modell wofür passt, oder verbraucht Limits zu schnell? Wir stellen den Workspace sinnvoll ein und zeigen im Workshop an euren eigenen Aufgaben, wann Auto reicht und wann ihr bewusst wählt. Gespräch mit uns vereinbaren
Maximilian Möhring ist CEO und Gründer von DECAID. Mit seinem Team bringt er Langdock in Unternehmen: von der Tool-Entscheidung über den Rollout bis zur Automatisierung konkreter Workflows. Aus mehr als 100 Langdock-Rollouts weiß er, woran KI-Einführungen scheitern und was es braucht, damit Teams KI im Alltag wirklich nutzen.