Wöchentliches KI-Briefing — direkt ins Postfach.
Danke! Schau in dein Postfach.
Mehr Newsletter-Formate →

Stand: 28.10.2026
Alle Beispiele haben wir im DECAID-Demo-Workspace mit der fiktiven Firma Quellberg getestet. Firmen, Preise und Zahlen im Praxisfall sind erfunden.
Kurz gesagt: Im Auto-Modus wählt Langdock für jeden Chat selbst ein Modell, abhängig davon, wie schwer die erste Nachricht ist. Das spart Nutzung, weil einfache Fragen nicht auf einem teuren Modell landen. In unserem Test liefen eine kurze Frage und eine Preisrechnung auf der einfachen Stufe, eine Preisoptimierung mit kritischer Prüfung auf der komplexen. Alle Rechenergebnisse stimmten. Wichtig ist die erste Nachricht: Dieselbe schwere Aufgabe lief als Folgefrage nach einer kurzen Frage auf der einfachen Stufe.
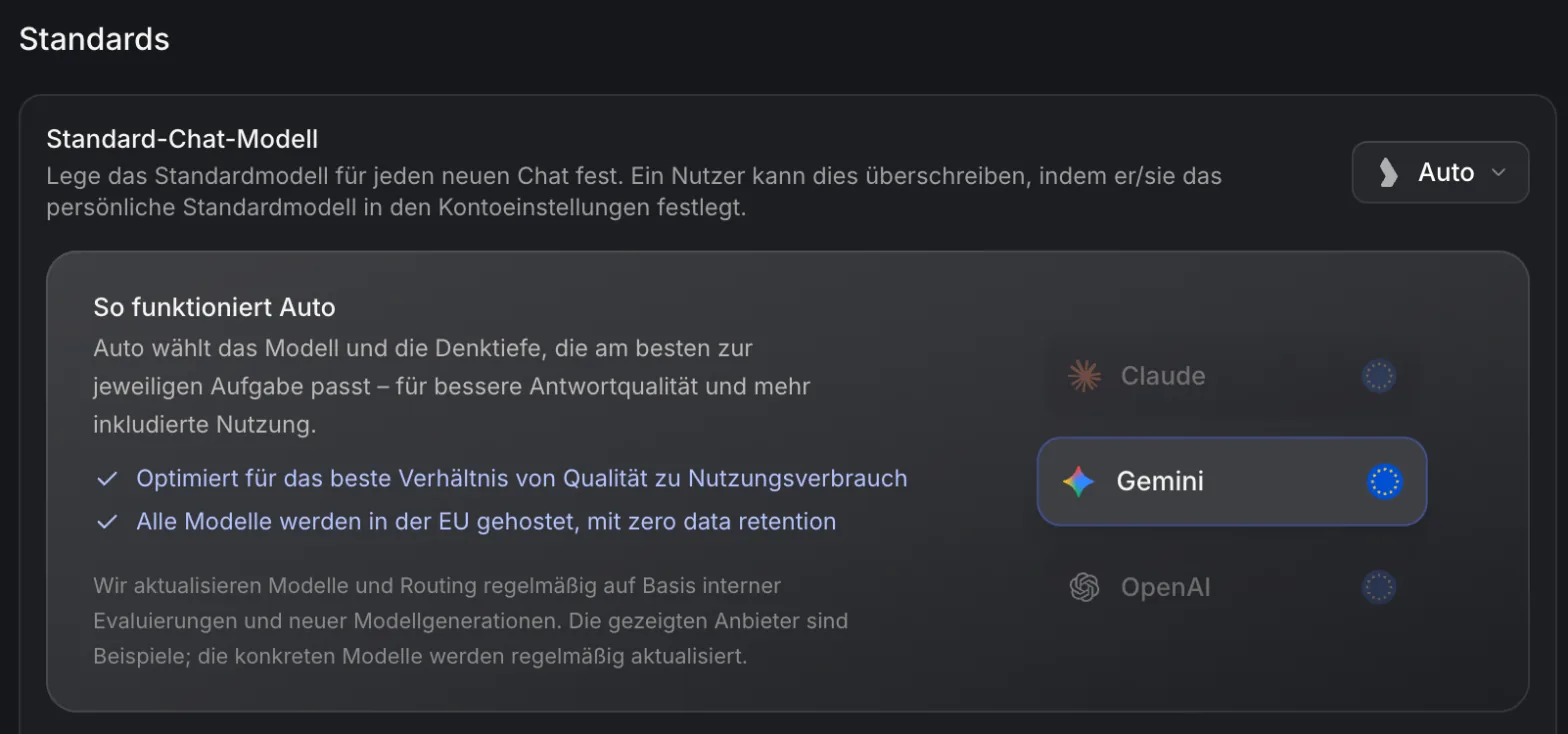
Auto ist ein Eintrag in der Modellauswahl, hinter dem Langdock je nach Aufgabe verschiedene Modelle einsetzt. Langdock schätzt die Komplexität deiner ersten Nachricht ein und wählt dann ein passendes Modell für das ganze Gespräch (Quelle: Langdock-Doku »Modellguide«). In den Workspace-Einstellungen beschreibt Langdock Auto so: »Auto wählt das Modell und die Denktiefe, die am besten zur jeweiligen Aufgabe passt«, optimiert für »das beste Verhältnis von Qualität zu Nutzungsverbrauch«. Alle Modelle sind dort als in der EU gehostet ausgewiesen.
Welche Modelle Auto nutzt, legt Langdock fest und ändert es regelmäßig. Die Oberfläche sagt dazu: »Die gezeigten Anbieter sind Beispiele; die konkreten Modelle werden regelmäßig aktualisiert.«
| Auto | Festes Modell | |
|---|---|---|
| Wer wählt | Langdock, einmal pro Chat | du |
| Denktiefe (Reasoning) | wählt Auto mit | stellst du im Menü ein |
| Verbrauch | niedrig bei einfachen Fragen | je nach Modell und Reasoning-Stufe |
| Gut für | Alltag: Fragen, Texte, Zusammenfassungen, Analysen | bewusst schwere Aufgaben, feste Agenten und Workflows |
| Nachteil | Stufe hängt an der ersten Nachricht | teure Modelle verbrauchen Limits auch bei Kleinigkeiten |
Quelle: Langdock-Doku »Modellguide« und »Nutzungs-Limits«, eigener Test 28.10.2026.
Für den ganzen Workspace (Admins): Unter Einstellungen › Workspace › Modelle steht oben Standard-Chat-Modell. Steht dort Auto, startet jeder neue Chat mit Auto.
Für dich: In den Account-Einstellungen unter Präferenzen legst du ein persönliches Standardmodell fest, das den Workspace-Standard überschreibt (Quelle: Langdock-Doku »Modellguide« und Hinweis in den Workspace-Einstellungen).
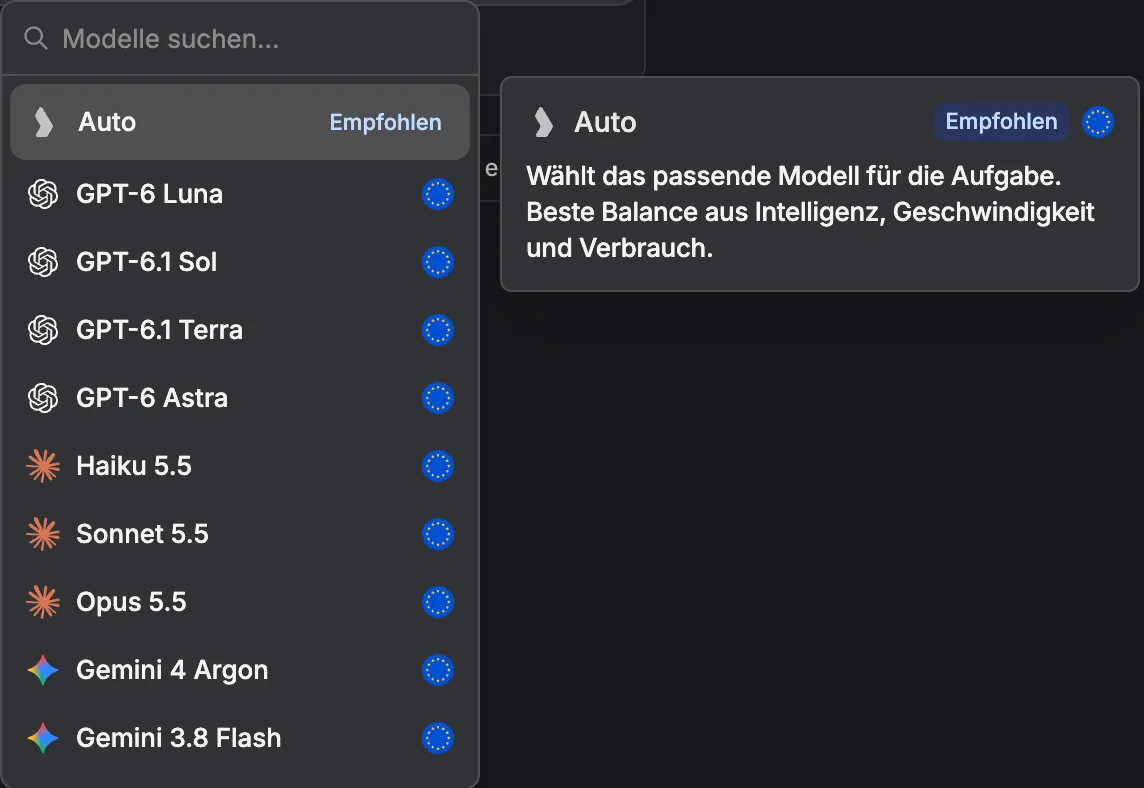
Im Chat: Die Modellauswahl im Eingabefeld zeigt Auto ganz oben mit dem Etikett Empfohlen. Wählst du ein festes Modell mit mehreren Denkstufen, erscheint im Menü zusätzlich die Zeile Reasoning mit einem Regler. Bei Auto fehlt diese Zeile, Auto wählt die Denktiefe selbst.
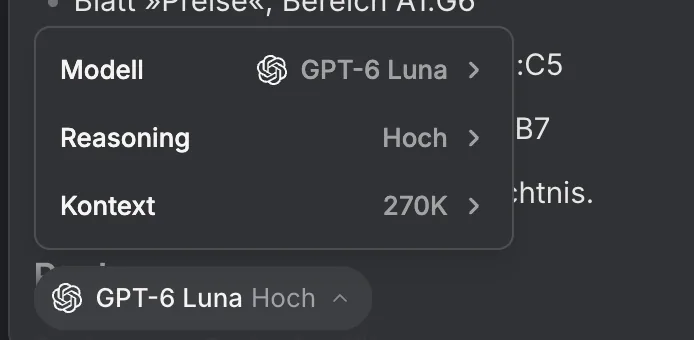
Im Agenten: Im Agenten-Editor sitzt die Auswahl unten im Anweisungsfeld. Steht ein Agent auf einem festen Modell, siehst du dort Modell und Reasoning, bei manchen Modellen auch die Kontextgröße. Steht er auf Auto, öffnet ein Klick direkt die Modellliste.
Quellberg will die Linie Zuckerfrei zum 01.01.2027 verteuern. Der Vertrieb fragt Langdock im normalen Chat, Standardmodell Auto. Welches Modell und welche Stufe liefen, haben wir in den Metadaten jeder Antwort nachgelesen. Die Oberfläche zeigt am Avatar der Antwort nur »Auto«.
Test 1, einfache Frage: »Wofür steht MHD auf Lebensmitteln? Ein Satz.« Stufe: einfach. Antwort richtig.
Test 2, Rechnen und Argumentieren: Neue Listenpreise bei 6 % Aufschlag auf 20,40 EUR je Kiste, dazu je zwei Einwände für Getränkemarkt, Gastronomie und Hofladen. Stufe: einfach. Die Antwort rechnete 21,62 EUR je Kiste und nannte, wie sich andere Rundungen auswirken (21,60 EUR wären 5,9 %, 21,70 EUR wären 6,4 %). Beides stimmt. Eine fehlende Angabe zum Kistenformat markierte sie als Annahme.
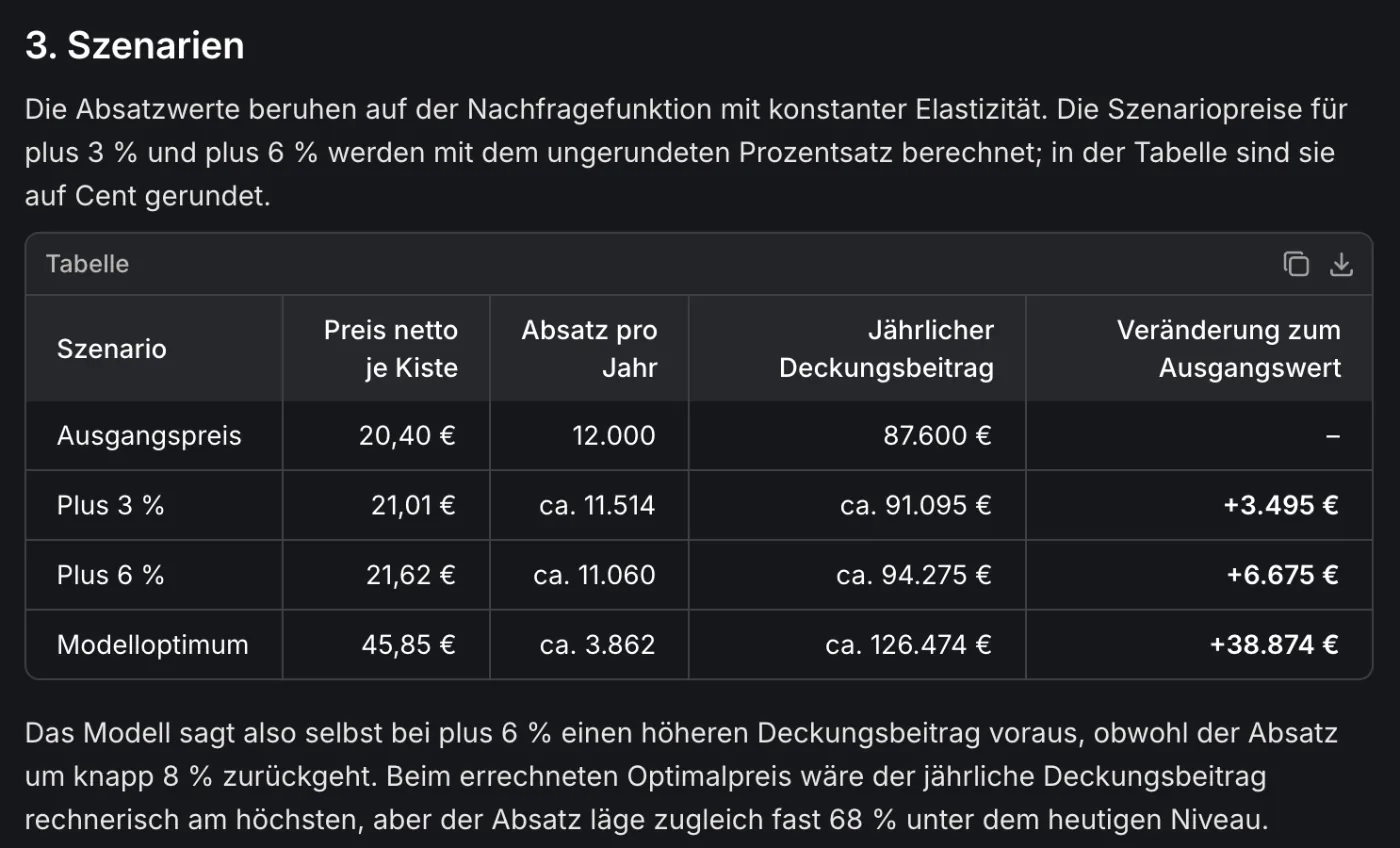
Test 3, Herleitung mit Kritik: Ausgangspreis 20,40 EUR, Preiselastizität −1,4, variable Kosten 13,10 EUR, Absatz 12.000 Kisten; gesucht der gewinnmaximierende Preis, Szenarien für +3 % und +6 % und eine kritische Prüfung des Modells. Stufe: komplex, mit Denkschritten und Code-Ausführung, fertig nach 36 Sekunden. Wir haben nachgerechnet: Der Modellwert von 45,85 EUR stimmt, ebenso die Deckungsbeiträge von 91.095,18 EUR bei +3 % und 94.274,99 EUR bei +6 % (die Antwort rundet auf ganze Euro). Die Antwort empfahl, den Modellwert nicht umzusetzen, weil er fast 125 % über dem heutigen Preis liegt und die geschätzte Elastizität so weit kaum trägt, und zuerst +3 % zu testen.
Alle Befunde stammen aus Tests am 28.10.2026 im Quellberg-Workspace (Cloud, ohne BYOK).
1. Die erste Nachricht legt die Stufe für den ganzen Chat fest. So beschreibt es die Doku, und unsere Gegenprobe bestätigt es: Wir haben einen neuen Chat mit der MHD-Frage begonnen und danach die Elastizitätsaufgabe aus Test 3 geschickt. Als erste Nachricht lief sie auf der komplexen Stufe, als Folgefrage blieb sie auf der einfachen. Die Rechnung stimmte trotzdem, die Antwort kam aber ohne Code-Ausführung aus. In der Oberfläche siehst du davon nichts. Für schwere Aufgaben heißt das: neuen Chat beginnen und die Aufgabe gleich vollständig in die erste Nachricht schreiben. Oder vor der schweren Frage bewusst ein festes Modell wählen.
2. Auto stuft streng ein. Eine Aufgabe mit Rechnung und drei Zielgruppen galt als einfach, erst die mehrstufige Herleitung mit kritischer Prüfung als komplex. Für Alltagsaufgaben war das in unseren Tests kein Nachteil, alle Zahlen stimmten. Wer eine Analyse mit hoher Tragweite braucht, schreibt die ganze Aufgabe mit Herleitung und kritischer Prüfung in die erste Nachricht. So formuliert, stufte Auto unseren Test 3 als komplex ein. Welches Merkmal den Ausschlag gab, haben wir nicht einzeln geprüft.
3. Agenten mit Auto werden im Chat genauso eingestuft. Unser Agent »Lieferzusage« steht auf Auto. Eine Lieferterminfrage lief einfach, die Elastizitätsaufgabe komplex, wie im normalen Chat. Im Chat passt Auto also auch für Agenten, die mal kurze und mal schwere Fragen bekommen. Für Agenten, die per API oder immer gleich laufen sollen, siehe Befund 4.
4. Über die API wählt Auto anders. Dieselbe Elastizitätsaufgabe an denselben Agenten, diesmal über die Agents API: Im Datenstrom stand keine Stufe. Die schwere Aufgabe bekam zwar mehr Denkaufwand als eine leichte Frage, aber ein anderes Modell als im Chat. Das Ergebnis war trotzdem richtig. Wer Agenten per API einbindet und reproduzierbare Ergebnisse braucht, stellt sie auf ein festes Modell. Laut Release Notes v7.21 nimmt die Agent API auto an. In unserem Test galt das nur für gespeicherte Agenten: Ein Inline-Agent mit model: "auto" und die Completion API lehnten Auto mit HTTP 400 ab. Mehr dazu in unserem Artikel zur Langdock API.
5. Welches Modell lief, siehst du in der Oberfläche nicht. Der Avatar zeigt nur »Auto«. Für Tests haben wir die Metadaten der Antworten ausgelesen. Im Alltag ist das kein Problem, für Vergleiche und Freigaben schon: Wenn ein Agent ein bestimmtes Modell braucht, etwa wegen interner Freigaben, gehört dieses Modell fest in den Agenten.
| Grenze | Was passiert | Workaround | Quelle |
|---|---|---|---|
| Stufe pro Chat | erste Nachricht bestimmt das Modell für den ganzen Chat | neuer Chat für schwere Aufgaben oder festes Modell wählen | Doku »Modellguide«, eigener Test 28.10.2026 |
| kein Reasoning-Regler | Denktiefe wählt Auto selbst | festes Modell mit Reasoning-Stufe | Doku »Modellguide« |
| Modell nicht sichtbar | Oberfläche zeigt nur »Auto« | für Vergleiche festes Modell wählen | eigener Test 28.10.2026 |
| API | Inline-Agenten und Completion API lehnen Auto ab; gespeicherte Agenten wählen anders als im Chat | festes Modell im Code und im Agenten | eigener Test 28.10.2026 |
| Workflows | Auto in Workflow-Knoten erst seit v7.24, von uns nicht getestet | festes Modell im Knoten | Release Notes v7.24 |
| Limits erreicht | ohne Extra-Nutzung Fallback-Modell bis zum Zurücksetzen | Extra-Nutzung oder höherer Plan | Doku »Nutzungs-Limits« |
Welche Modelle nutzt der Auto-Modus?
Das legt Langdock fest und aktualisiert es laufend auf Basis interner Tests. Die Oberfläche nennt Anbieter nur als Beispiele. Verlass dich deshalb auf das Prinzip: einfache Anfragen schnell und günstig, komplexe mit mehr Denkaufwand.
Ist Auto schlechter als ein festes Topmodell?
In unseren Tests nicht: Alle Rechenergebnisse stimmten, auch bei den einfach eingestuften Fragen. Eine einfach eingestufte Antwort hielt allerdings Mariä Empfängnis für einen möglichen Feiertag in Bayern, ohne Folgen für das Ergebnis. Für Aufgaben mit maximaler Tiefe empfiehlt auch die Doku, bewusst ein bestimmtes Modell zu wählen.
Wechselt Auto das Modell mitten im Chat?
Auto wählt bei der ersten Nachricht ein Modell und bleibt für das Gespräch dabei. In unserem Test lief eine Aufgabe, die als erste Nachricht komplex eingestuft wurde, als Folgefrage im selben Chat auf der einfachen Stufe. Neu generieren mit Auto (seit v7.24 möglich) änderte die Stufe in unserem Test am 30.10.2026 nicht. Du kannst jederzeit selbst ein anderes Modell wählen. Und erreichst du ein Nutzungslimit ohne Extra-Nutzung oder fällt ein Anbieter aus, laufen deine weiteren Nachrichten auf dem Fallback-Modell, bis das Limit zurückgesetzt wird oder der Anbieter wieder da ist (Quelle: Langdock-Doku »Modellguide« und »Nutzungs-Limits«, Release Notes v7.22).
Kann ich Auto für Agenten nutzen?
Ja. Im Chat stuft Auto die Fragen an einen Agenten genauso ein wie im normalen Chat. Über die API wählt Auto anders, dort ist ein festes Modell die sicherere Wahl.
Spart Auto wirklich Nutzung?
Langdock misst Nutzung über Tokens und den Preis des Modells. Wenn einfache Fragen auf einem günstigen Modell laufen, verbrauchen sie weniger vom Limit (Quelle: Langdock-Doku »Nutzungs-Limits« und »Modellguide«). In unserem Preis-Test am 28.10.2026 kostete die Elastizitätsaufgabe aus Test 3 mit einem Topmodell rund 10 Prozentpunkte der Fünf-Stunden-Session; mit Auto auf der komplexen Stufe bewegte sich die Anzeige nicht sichtbar. Mehr dazu in unserem Artikel zu Langdock-Preisen.
Was passiert mit Auto, wenn mein Limit erreicht ist?
Mit Extra-Nutzung arbeitest du normal weiter. Ohne Extra-Nutzung laufen deine Nachrichten auf einem Fallback-Modell, bis das Session- oder Wochenfenster zurückgesetzt wird. Ein Ausgabenlimit des Workspace kann das früher auslösen (Quelle: Langdock-Doku »Nutzungs-Limits«).
Kann ich Auto abschalten?
Ja, für dich selbst: Wähle in den Präferenzen ein festes Standardmodell oder im Chat ein anderes Modell. Admins ändern das Standard-Chat-Modell für den ganzen Workspace. Einen Schalter, der Auto für alle aus der Modellauswahl nimmt, gab es auf der Seite Modelle am 30.10.2026 nicht.
Euer Team verbraucht Limits schneller als gedacht oder ist unsicher, wann welches Modell passt? Wir stellen den Workspace sinnvoll ein und zeigen im Workshop, wann Auto reicht und wann ihr bewusst wählt. Gespräch mit uns vereinbaren
Maximilian Möhring ist CEO und Gründer von DECAID. Mit seinem Team bringt er Langdock in Unternehmen: von der Tool-Entscheidung über den Rollout bis zur Automatisierung konkreter Workflows. Aus mehr als 100 Langdock-Rollouts weiß er, woran KI-Einführungen scheitern und was es braucht, damit Teams KI im Alltag wirklich nutzen.